신발까지 다 젖었어 👟💦
이모지를 쓰려면 이름을 알아야 합니다.
Slack에서는 :tada:를 쳐야 하고, 맥의 이모지 창에서는 party popper를 검색해야 해요. 제가 고르고 싶은 건 이름이 아니라 느낌인데 말이죠.
맥에는 영어 단어를 치면 커서 옆에 이모지를 띄워 주는 기능이 있습니다. 편해요. 근데 단어 하나만 보고, 영어만 됩니다. 비슷한 앱들도 찾아봤는데 대부분 이모지 이름을 알아야 하고, 역시 영어만 되더라고요.
그래서 문장을 읽고 이모지를 골라 주는 앱을 만들었습니다.
emote는 메뉴 막대에 사는 앱입니다. 글을 쓰다가 ⌃⌘E를 누르면 커서 옆에 이모지가 몇 개 뜹니다. Tab이나 화살표로 고르고 Enter를 누르면 쓰던 자리에 들어갑니다. 마음에 드는 게 없으면 한 번 더 누르면 돼요.
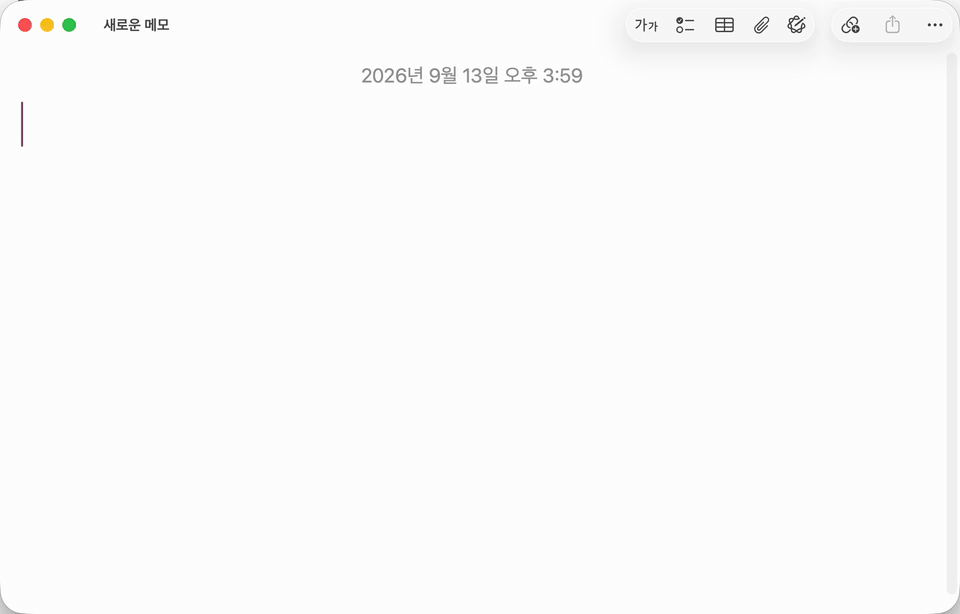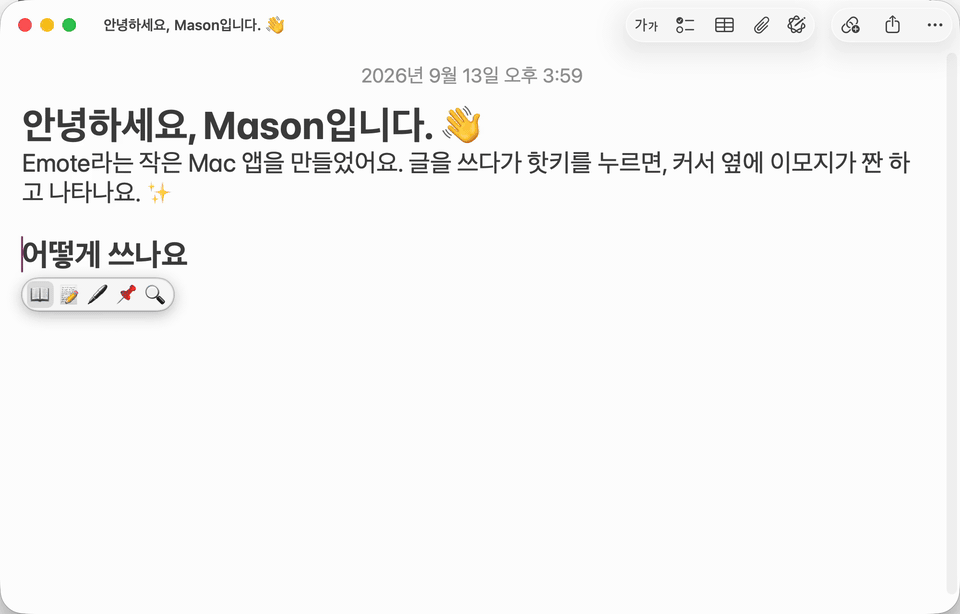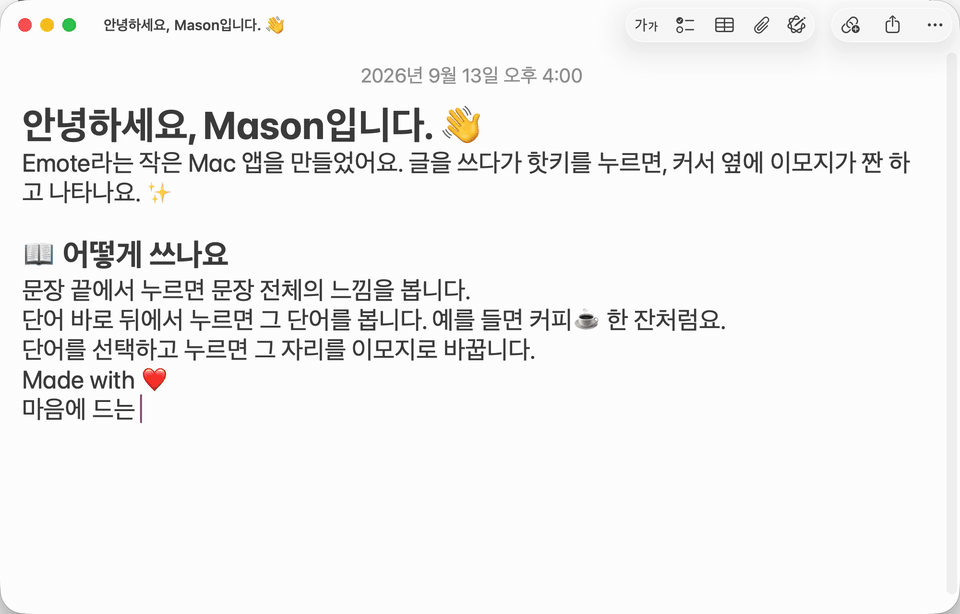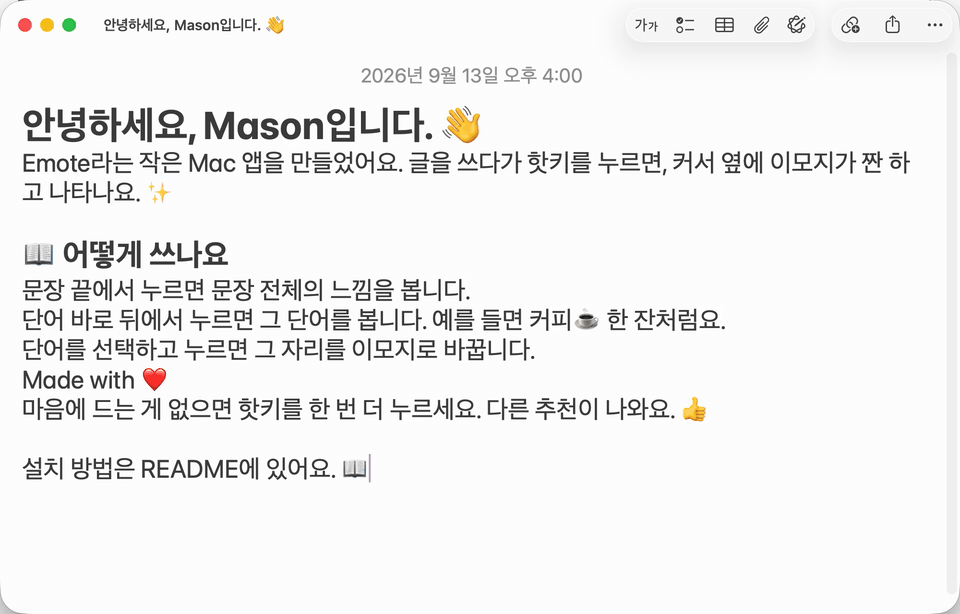
커서가 어디 있느냐
같은 핫키인데, 커서가 어디 있느냐에 따라 묻는 게 달라집니다.
문장 끝에서 누르면 그 문장을 봅니다. 오늘 퇴근길에 갑자기 비가 쏟아져서 신발까지 다 젖었어. 뒤에서 누르면 비, 우산, 젖은 신발, 그리고 한숨 같은 게 나와요.
단어 바로 뒤에서 누르면 그 단어를 봅니다. 커피 뒤에서 누르면 ☕. 대신 그 단어가 들어 있는 문장도 같이 넘깁니다. 차가 마시는 차인지 타는 차인지는 문장을 봐야 아니까요. 단어를 선택하고 누르면 그 단어를 이모지로 바꿉니다.
줄 맨 앞에서 누르면 제목으로 봅니다. 문장 끝 부호가 없는 줄이면요. 제목 앞에 붙는 이모지는 감정보다 주제를 나타내야 하잖아요. 설치 방법 앞에는 😊보다 🛠️가 어울립니다. 그래서 제목 모드에서는 다음 줄의 첫 문장까지 같이 읽고, 그 절이 무슨 내용인지를 봅니다.
일본어와 중국어는 띄어쓰기가 없습니다. 그러면 “단어 바로 뒤”를 알 수가 없죠. 이건 macOS에 있는 단어 분리기(NLTokenizer)에 맡겼습니다. 일본어, 중국어 단어 경계는 시스템이 알아서 잡고, 한국어는 조사가 붙은 어절 그대로 나옵니다.
톤은 사실을 못 바꿔
설정에서 톤을 고를 수 있습니다. neutral, dry, warm, playful. 네 개입니다.
처음엔 톤이 중요하다고 생각했어요. 써 보니 아니었습니다. 톤보다 맥락이 먼저입니다.
신발까지 다 젖었어를 warm으로 받으면 어떻게 될까요. 여러 모델에 같은 문장을 넣어 봤습니다.
Apple 온디바이스 모델: 😊 😌 😅 😍
Qwen3 4B: 🌧️ 😅 🤗 💡 ❤️ 🙏 🌈 😊 ✨ 😌
비가 사라졌습니다. 하트랑 무지개가 떴고요. 따뜻하게 말해 달랬더니 비 맞은 퇴근길을 좋은 일로 만들어 버린 거예요.
Gemma 4 E4B: ☔️ 🌧️ 😭 🚶♀️ 💧 😔
이게 맞죠. 비는 그대로 오고, 조금 더 다정하게 슬퍼합니다. 톤은 분위기만 바꾸고, 문장이 무슨 이야기인지는 바꾸지 않아야 합니다.
비교한 모델은 열 개입니다. Gemma 4 E2B와 E4B, Qwen3 4B, Qwen2.5 1.5B와 3B, Llama 3.2 3B, Ministral 3B, SmolLM3 3B, EXAONE 4.0 1.2B, 그리고 Apple 온디바이스 모델. 한국어, 영어, 일본어, 중국어 문장과 제목을 섞어서 M3 Pro에서 돌렸습니다. 세 모델은 이모지 목록 자체를 못 만들었어요. 한자를 반복하거나, 같은 조각을 끝없이 뱉거나.
Gemma 4 E4B가 제일 나았습니다. 그래서 지금 emote의 기본 엔진은 Gemma 4 E4B입니다. 맥 안에서 돌고, 문장은 밖으로 나가지 않습니다.
Apple 온디바이스 모델을 뺀 게 덤으로 좋았던 점도 있어요. 그 모델은 macOS 26 Tahoe부터, 그것도 Apple Intelligence를 켜야 쓸 수 있습니다. Gemma는 그런 조건이 없어서 Sonoma에서도 돌아갑니다. 컴퓨터가 버거우면 OpenAI 호환 API로 바꿀 수도 있습니다. OpenAI, OpenRouter, Groq 같은 곳이요.
빠른 게 제일 중요하진 않아
bdsk를 만들 때는 속도가 전부였습니다. 정확도가 조금 낮아도 제일 빠른 모델을 골랐어요. emote도 그럴 줄 알았습니다.
LLM은 느립니다. 글자를 하나씩 만들어 내야 하니까요. 그래서 글자를 만들지 않는 방법을 두 번 시도했습니다.
System-one 결정 모델
요즘 Jev가 엄청 유명하잖아요. TypeSafe에서 나온 System-one 모델이요. LLM처럼 답을 한 글자씩 쓰지 않고, 선택지를 주면 각각의 확률을 바로 돌려줍니다. 그러니 빠르죠. 이모지 고르기에 딱이다 싶었어요.
문제는 선택지 수였습니다. 이모지는 수천 개인데, 한 번에 줄 수 있는 선택지는 그보다 훨씬 적거든요. 그래서 트리를 만들었습니다. 대분류 몇 개를 고르고, 그 아래 중분류, 다시 소분류로 내려가면서 세 번 묻는 방식이에요. Jev 계열의 작은 모델(Jev-Style 0.8B)로 실험했고, 문장 하나에 0.5초면 끝났습니다.
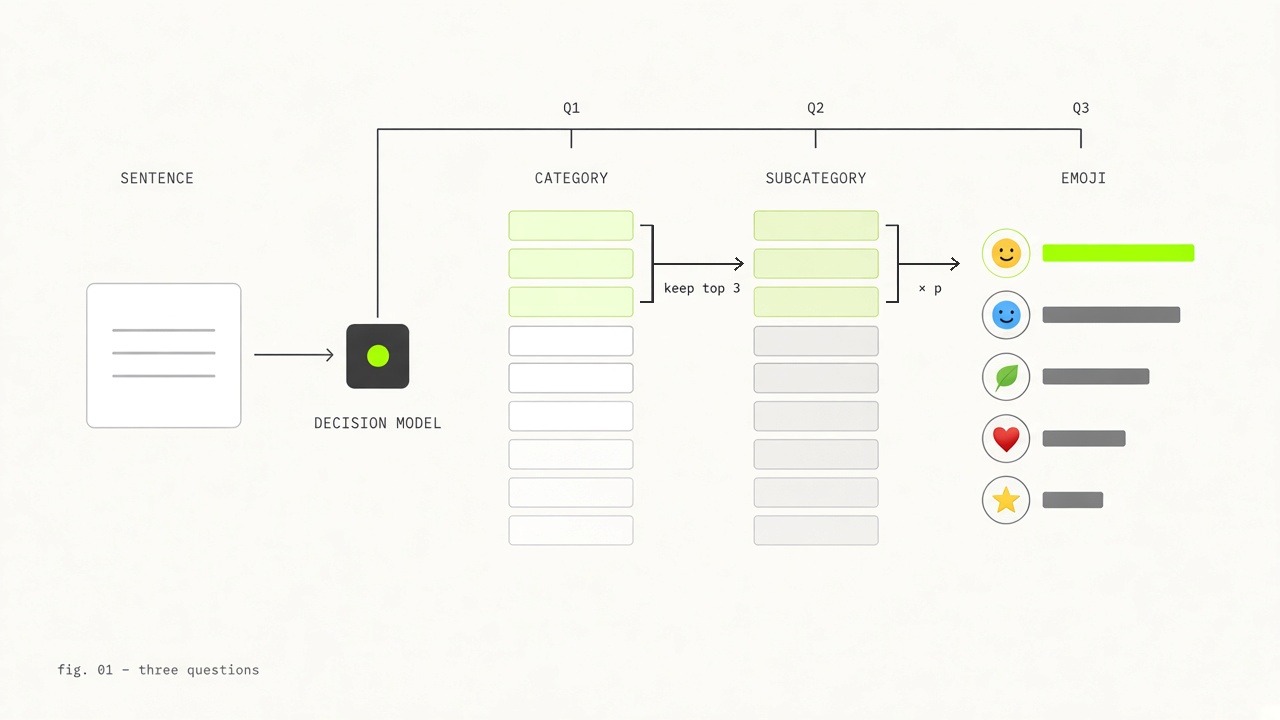
속도는 좋았는데, 써 보니 엉망이었어요.
트리는 한번 갈래를 고르면 돌아오지 않습니다. 🤖는 유니코드 분류로는 얼굴 쪽, 유령이랑 외계인 옆에 있어요. 첫 질문에서 사물로 내려가면 로봇은 다시 못 만납니다. Good morning도 인사로 내려가면 ☀️는 나올 수가 없고요. 이모지 하나는 여러 뜻에 걸쳐 있는데, 트리는 한 자리에만 둡니다.
결국 분류 방식은 트리를 어떻게 짜느냐에 따라 전혀 다르게 동작합니다. 감정으로 나눌지, 사물로 나눌지, 상황으로 나눌지. 상황으로 나누면 출시 같은 칸이 생기는데, 그건 저 같은 사람한테나 맞는 분류죠. 추천 품질을 위해 트리 단계를 늘리면 질문 수가 늘어서 system-one 모델의 장점인 속도를 잃어요.
트리를 몇 번 갈아엎었지만, 한쪽을 고치면 다른 쪽이 틀렸습니다. 모든 문장에 맞는 트리가 있기는 한지도 모르겠어요. 있다 해도 엄청 고민해야 찾을 수 있을 겁니다.
나만의 모델을 훈련
두 번째는 직접 모델을 훈련하는 것이었습니다. 다국어 문장 인코더(multilingual-e5-small) 위에 이모지 1,854개의 확률을 뱉는 머리를 붙였어요. 더 큰 Gemma 4가 고르는 이모지를 따라 하도록 가르치는 거예요. 그러려면 Gemma 4한테 물어서 데이터셋부터 만들어야 했는데, 이게 정말 오래 걸렸습니다. 웹에서 일상, 위키 등 다양한 문장을 다국어로 수집하고 Gemma 4한테 추천을 받았어요.
빨랐습니다. 한 번에 9ms. Gemma 4 E4B는 577ms니까 60배쯤 빠르죠. 그런데 신발까지 다 젖었어에 이렇게 답했습니다.
랭커: 📉 ☁️ 🌫️ ☔ 🙄
Gemma 4 E4B: 🌧️ 🚶♀️ 😩 💧
비 맞은 퇴근길에 📉는 좀 아니죠. 여덟 에폭까지 돌려 봤는데 크게 달라지지 않았습니다.
훈련을 더 하는 것보다 데이터셋을 어떻게 만드느냐가 관건일 것 같아요. 어떤 문장을, 어떤 상황에서, 얼마나 고르게 담느냐. 그런데 사실상 개인이 사람들이 실제로 쓸 문장을 다 담는 데이터셋을 수집하고 모델을 훈련하는 건 어려워보이네요.
받아쓰기는 말하고 바로 글이 나와야 합니다. 이모지는 아니더라고요. 핫키를 한 번 누르고, 뜬 것 중에 고르면 끝입니다. 0.6초는 기다릴 만하고, 엉뚱한 이모지는 다시 눌러야 합니다. 그래서 두 실험은 접었습니다.
Overview
한동안 제목 모드가 이상했습니다. 대표적인 게 Overview였어요. 다음 줄이 비어 있으면 아무리 눌러도 아무것도 안 나왔습니다.
같은 Gemma 4 E4B를 Ollama에 올려서 같은 지시문을 보내 봤어요. 잘 나옵니다.
📊 🗺️ 🧭 ℹ️ ✨
모델은 같은데 왜 앱에서만 안 될까요.
Ollama나 vLLM 같은 엔진은 모델 앞뒤로 해 주는 일이 많습니다. 지시문을 모델이 알아듣는 대화 형식으로 감싸 주고, 생각하는 단계를 꺼 주고, 답을 원하는 JSON 모양으로 받아 줍니다. 우리는 요청에 옵션만 적으면 돼요.
앱 안에 모델을 직접 넣으면 그걸 다 제가 해야 합니다. 그리고 처음엔 잘못했어요.
특히 JSON 부분이요. 앱은 모델의 답을 {"emojis":[까지 미리 써 두고 그 뒤를 이어 쓰게 했습니다. 이모지를 5개에서 10개 달라고 지시문에 적어 두긴 했지만, 그건 부탁일 뿐이에요. Overview는 주제가 아니라 문서의 구조 이름이라 그릴 게 없습니다. 그러면 모델은 바로 ]를 씁니다. 그렇게 {"emojis":[]}, 빈 목록이 됩니다.
Ollama는 JSON 스키마를 주면 모양에 맞지 않는 글자를 아예 뽑지 못하게 막습니다. 목록이 다섯 개가 안 됐으면 ]를 쓸 수가 없어요. 부탁이 아니라 강제인 거죠.
그래서 앱도 그렇게 바꿨습니다. 지금은 이모지 5개에서 10개짜리 목록 모양에 맞는 글자만 뽑습니다. 지시문도 제자리에 넣고, 생각하는 단계도 제대로 끕니다. Overview도 이제 나옵니다.
📄 🧭 ℹ️ 🗺️ ⚫
⚫는 왜 나왔는지 모르겠지만요.
“오늘 퇴근길에 갑자기 비가 쏟아져서 신발까지 다 젖었어. 😩”
설치 파일은 GitHub에 있습니다.