타입 위스퍼로 🎙️
손은 말을 못 따라갑니다.
2010년 기준 한컴타자연습에 기록을 올린 사람 만 명의 평균이 분당 300타였습니다. 말은 한국 사람이 자유롭게 이야기하면 분당 400자가 넘습니다. 300타는 글자 300개가 아니에요. 한글은 한 글자에 키를 두세 번 누릅니다. 글자로 바꾸면 분당 100자에서 150자입니다. 그러니까 말이 손보다 네 배 가까이 빠른 셈이죠.
그래서 STT(Speech-to-text) 앱을 쓰기 시작했습니다. Cursor, ChatGPT, Claude 때문은 아닙니다. 그 앱들은 받아쓰기가 따로 있고, 성능도 더 좋습니다. 다만 그 창 안에서만 되잖아요. 메일, 메모, 브라우저. 글자가 들어가는 곳이면 어디든 쓰고 싶었습니다.
처음에는 TypeWhisper를 썼습니다. 좋은 앱이에요. 유명하고요. 사전에 넣어 둔 단어는 잘 받아 적고, 한 번 고친 말도 다음부터 그렇게 나옵니다.
근데 한국어는 계속 실패했습니다.
조사만 붙어도 실패
타입 위스퍼를 TypeWhisper로 고치도록 사전에 등록했어요. 그 단어만 말하면 잘 됩니다. 하지만 타입 위스퍼로라고 말하면 TypeWhisper로가 나와야죠. 그런데 결과는,
타입 위스퍼로
한국어에서는 “은”, “는”, “이”, “가” 등 조사가 단어에 바로 붙고, 띄어쓰기는 없습니다. 그래서 안 되는 거예요. 사전에 있는 말은 타입 위스퍼인데, 엔진이 들은 말은 타입 위스퍼로입니다. 앱이 그 둘을 다른 단어로 인식하거든요.
조사마다 등록하면 되지 않나 싶죠. 타입 위스퍼로, 타입 위스퍼에서, 타입 위스퍼로는 … 단어 하나에 붙을 수 있는 말을 전부 사전에 넣는 건 불가능에 가깝습니다.
그래서 한국어만을 위한 STT 앱을 만들었어요.
bdsk는 단어만 등록합니다. 깃허브만 넣으면 GitHub에, GitHub에서, GitHub로는이 됩니다. 입니다, 이에요, 이니까처럼 조사는 아닌데 바로 붙는 말도 남겨 둡니다. 메이슨을 넣어 두면 안녕하세요 Mason입니다가 돼요.
뒤에 붙은 한글을 다 자르지는 않습니다. 스위프트 데이터링의 링처럼, 목록에 없는 말이 이어지면 그대로 둡니다.
TypeWhisper와 bdsk에 둘 다 GitHub, Notion, PR 을 사전에 올려두고 사용해봅니다. 단어만 따로 말하면 둘 다 고쳐지지만 문장으로 말하면 bdsk 쪽만 정확히 바뀝니다.
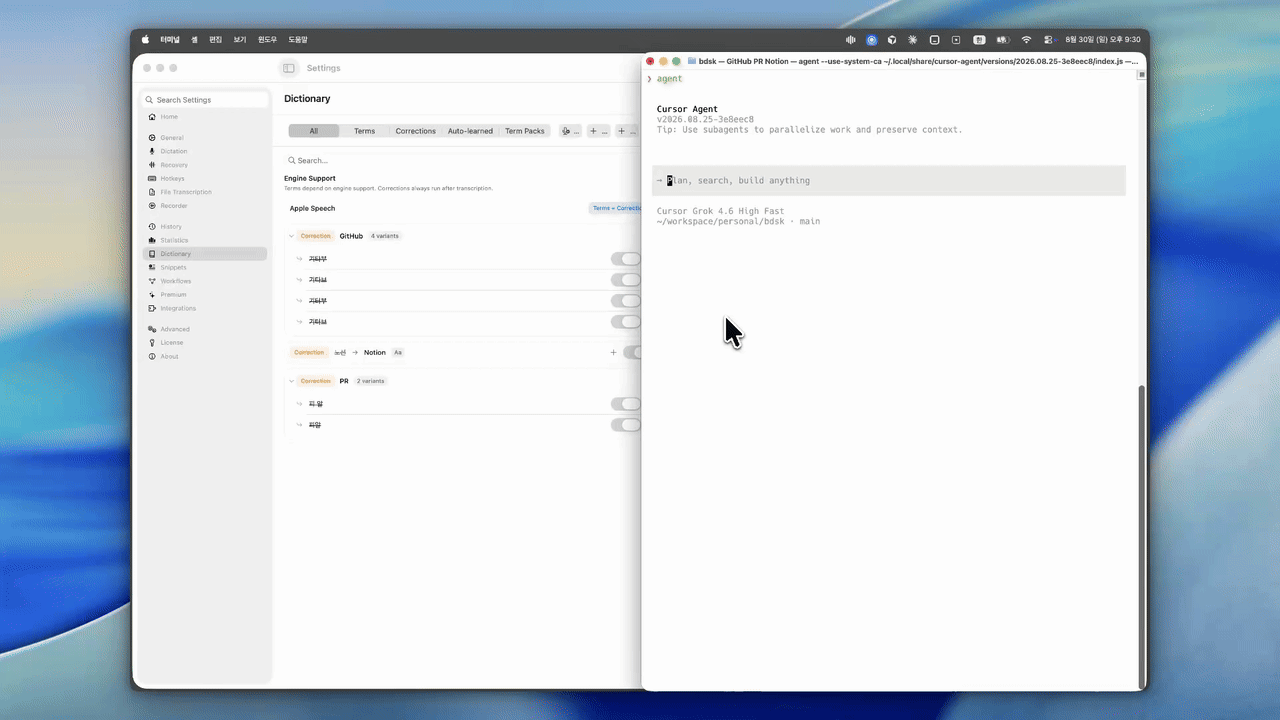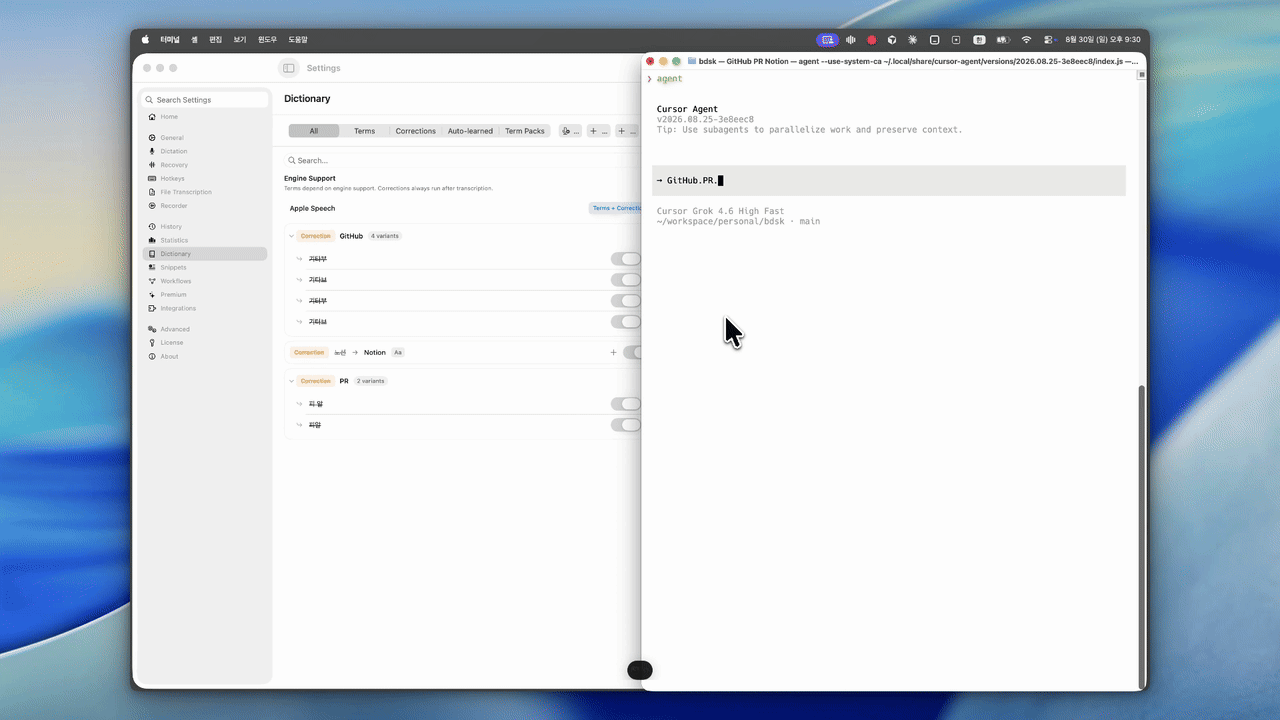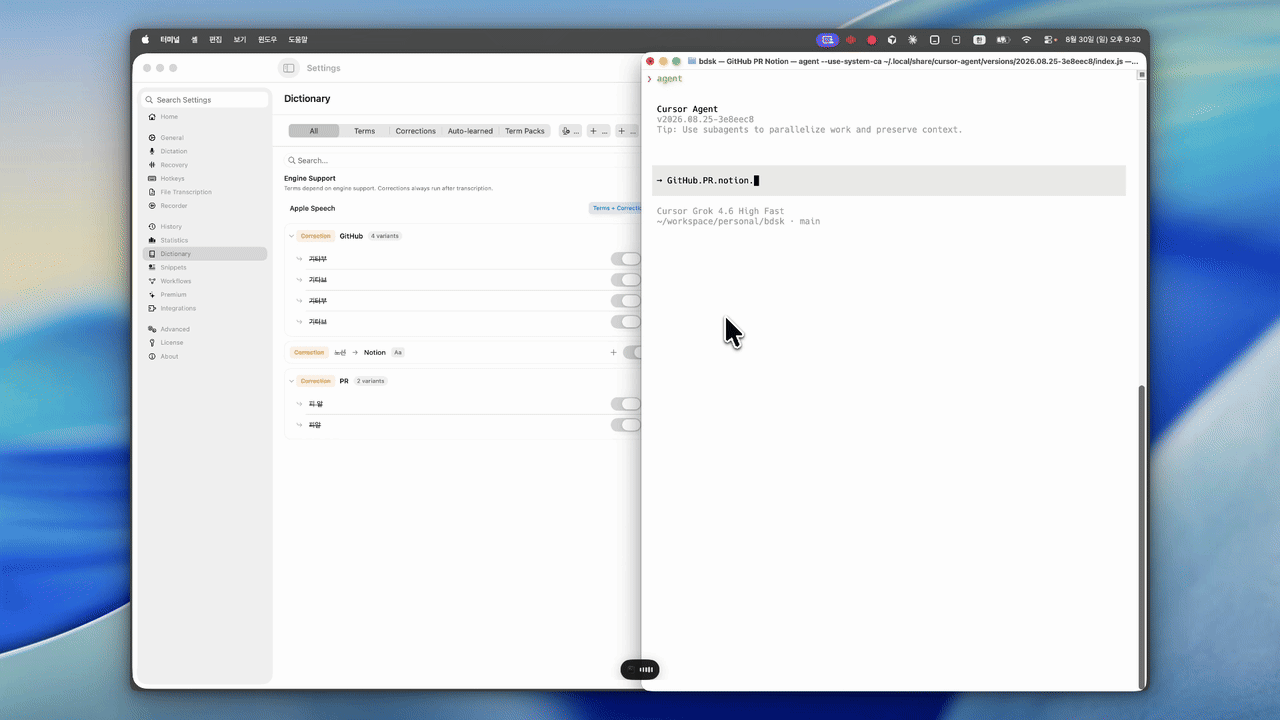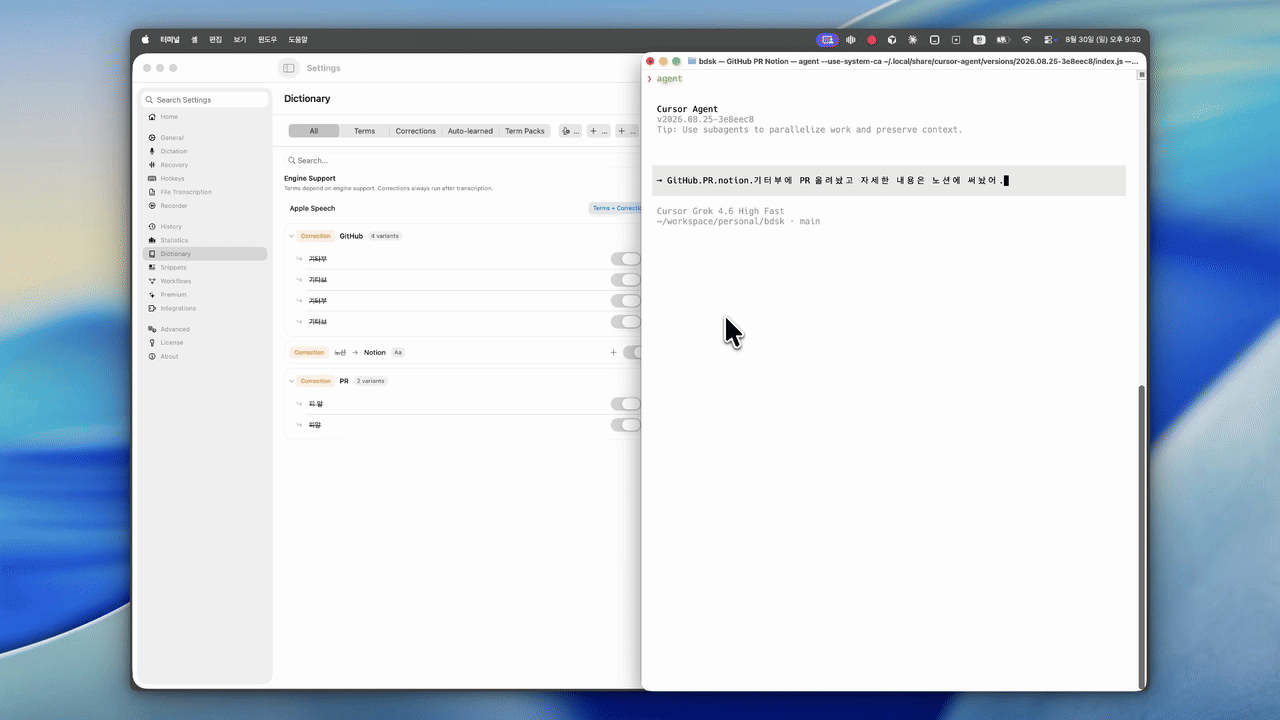
TypeWhisper. 기터부에 PR 올려놨고 자세한 내용은 노션에 써놨어.
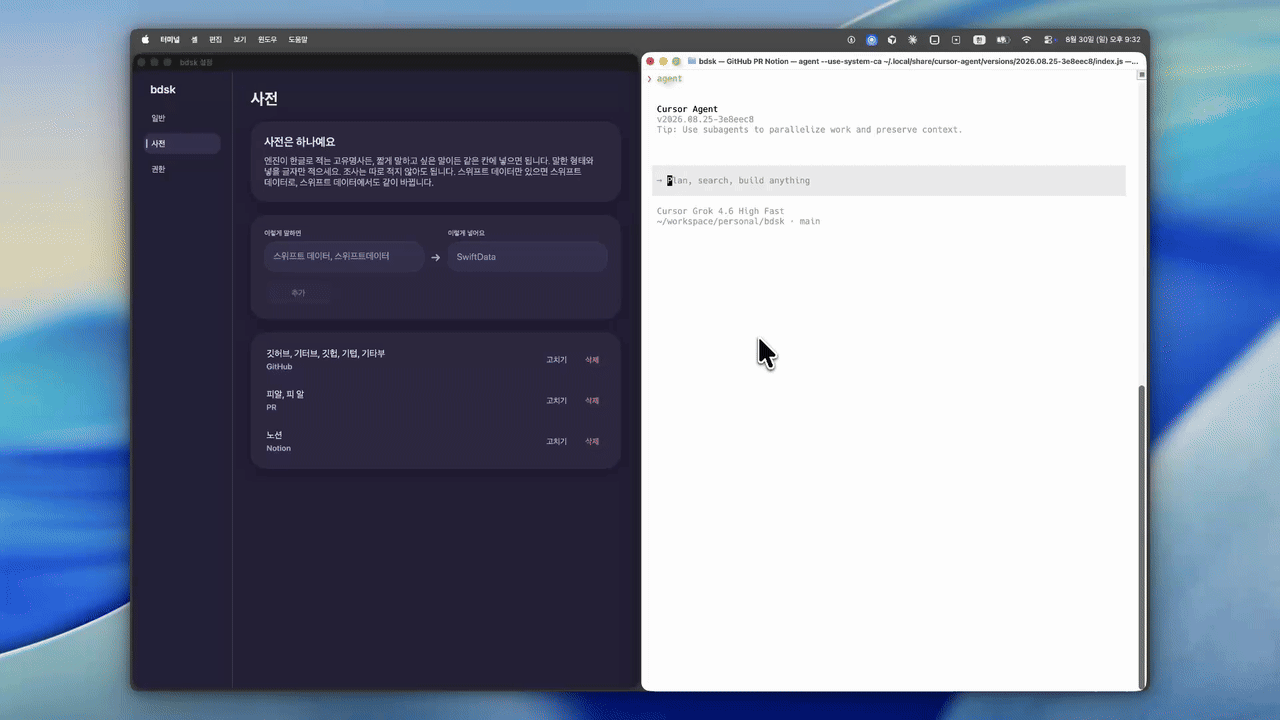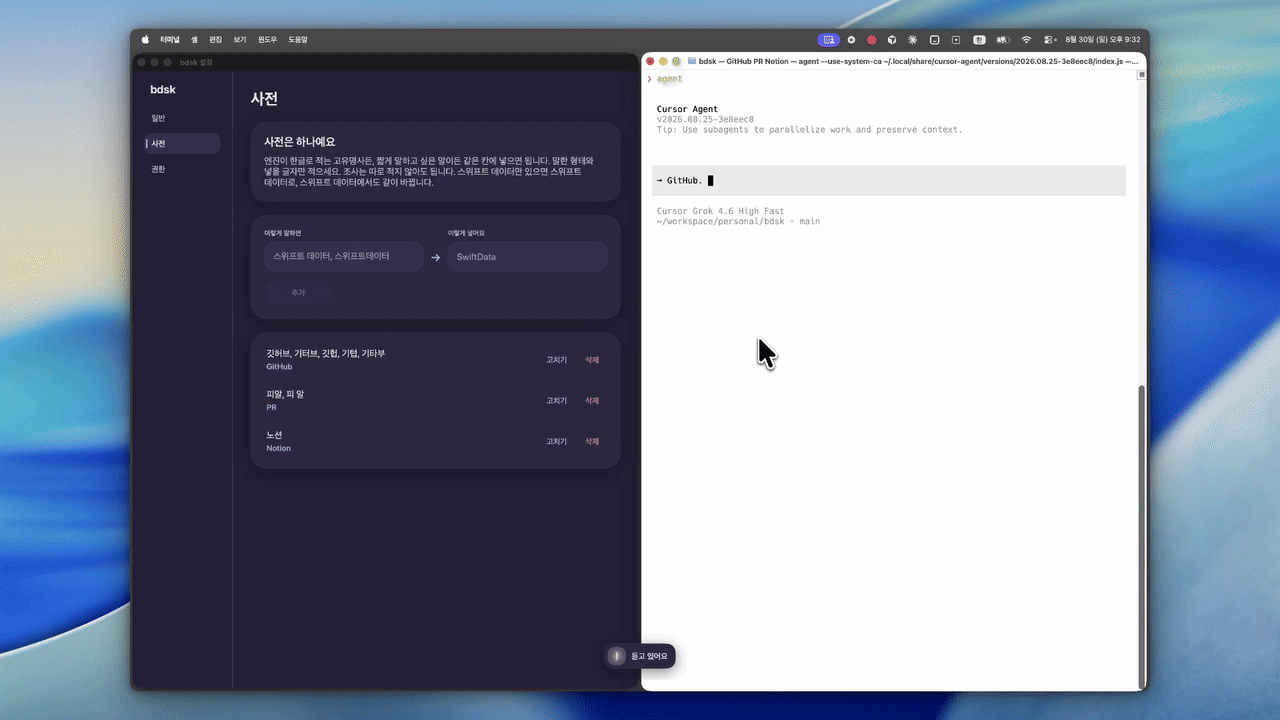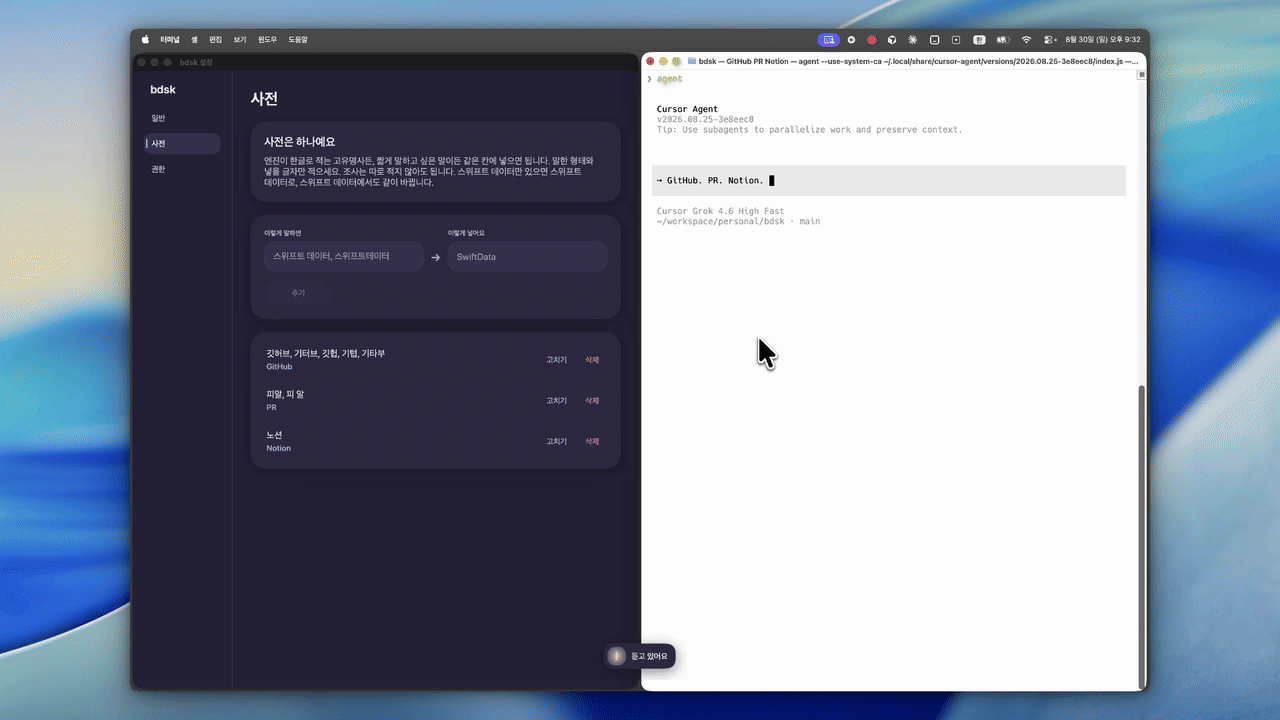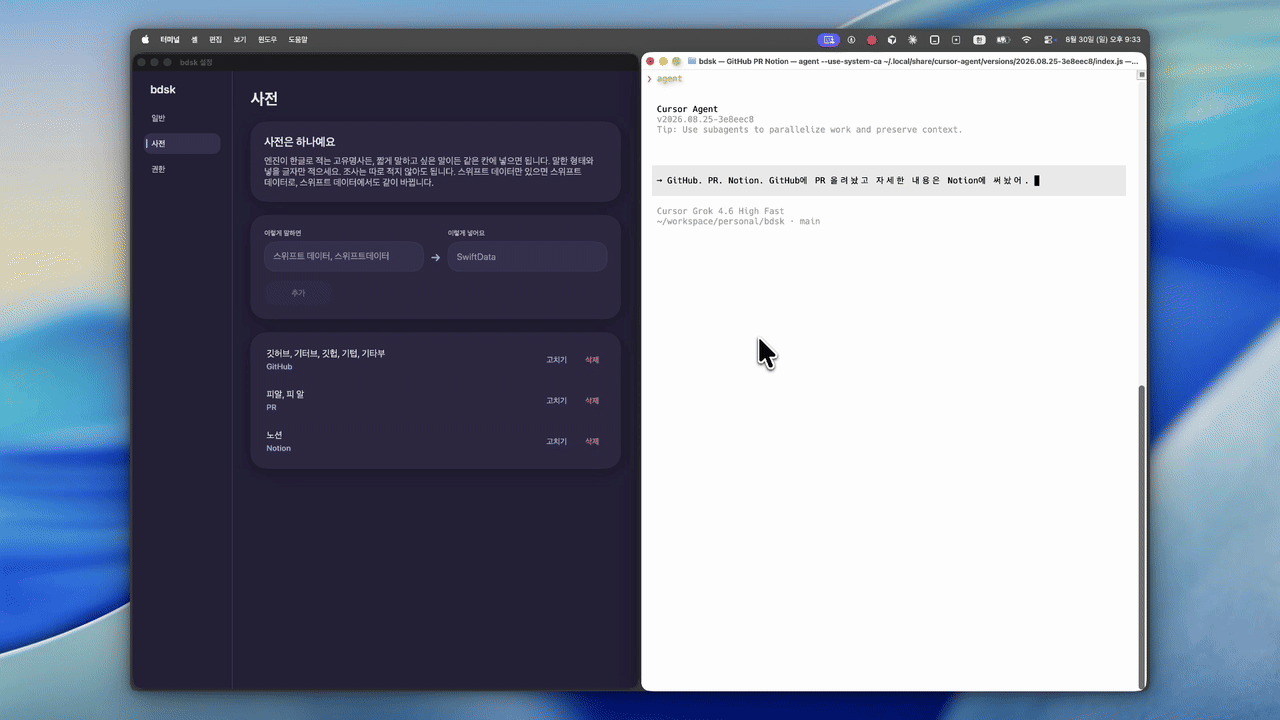
bdsk. GitHub에 PR 올려놨고 자세한 내용은 Notion에 써놨어.
빠른 게 제일 중요해
TypeWhisper는 모델을 고를 수 있습니다.
컴퓨터가 좋으면 로컬 모델을 쓰면 되고, 아니면 API도 쓸 수 있어요. 제 맥이 그렇게 좋은 편은 아니고, 받아쓰기에 돈을 낼 생각은 없었습니다. 그러니 로컬 모델을 쓸 수밖에요.
속도가 제일 중요하다고 생각했거든요. 그래서 여러 모델을 실험해봤어요.
일상, 출장, 경영, 투자, 개발, 제품. 한글이랑 영어가 섞인 문장을 여섯 개 녹음했고, 합치면 106초입니다. 맞혀야 할 이름은 54개예요. M3 Pro에서 돌렸습니다.
Apple SpeechAnalyzer는 macOS Tahoe, 그러니까 26부터 있는 받아쓰기입니다. 받아쓰기에서 가장 널리 쓰이는 모델은 Whisper turbo인 것 같았고요. 총 다섯 가지 모델을 테스트했습니다.
SpeechAnalyzer는 1.2초에 끝났습니다. 말을 하면서 기다린 시간은 아닙니다. 워밍업 뒤에, 106초 녹음을 파일로 받아 적는 데 걸린 시간입니다. 어마어마하죠? 뉴럴 엔진에서 돌아서 빠른 거라고 하더라고요. 54개 이름 중 40개를 맞혔습니다. Qwen 1.7B는 51개를 맞혔는데 79초가 걸렸습니다. 같은 녹음을 WhisperKit으로 돌려도 7.4초, 48개였습니다.
SpeechAnalyzer가 놓친 건 짧은 영어 약어였습니다. CAC, CTA, FAB 같은 것. term sheet는 SpeechAnalyzer도 팀 시트로 들었고, Qwen이랑 Whisper도 그랬습니다. 어느 쪽이든 사전으로 고치면 됩니다.
받아쓰기는 말하고 바로 글이 나와야 합니다. 틀린 이름은 사전으로 고치면 되고, 79초는 기다릴 수가 없어요. Apple SpeechAnalyzer만 남겼습니다.
문제는 Sonama인데, 이 버전에는 SpeechAnalyzer가 없습니다. 대신 예전부터 있던 SFSpeechRecognizer가 있어요. 써 보니 꽤 나쁘지 않더라고요. 지금은 Tahoe에서는 SpeechAnalyzer를 쓰고, macOS 14부터는 SFSpeechRecognizer를 씁니다.
한 분이랑 1분
하나, 둘, 셋. 1, 2, 3. 둘 다 숫자인데, 엔진이 가끔 섞어서 받아 적습니다. 한 시에서 두 시 사이에 전화할게가 1시에서 2시로 나와요. 한 분이랑 1분은 뜻도 다릅니다.
1시에서 2시 사이에 전화할게나 한 시에서 두 시 사이에 전화할게나, 둘 다 틀린 문장은 아닙니다. 그래서 앱이 정하지 않고 고를 수 있게 했어요. 시, 분, 개 같은 단위가 붙으면 바로 넣지 않고, 작은 창에서 고른 뒤에 넣습니다. 그 단위가 보이면 매번 묻습니다. 지난번에 고른 걸 기억해 두지는 않습니다.
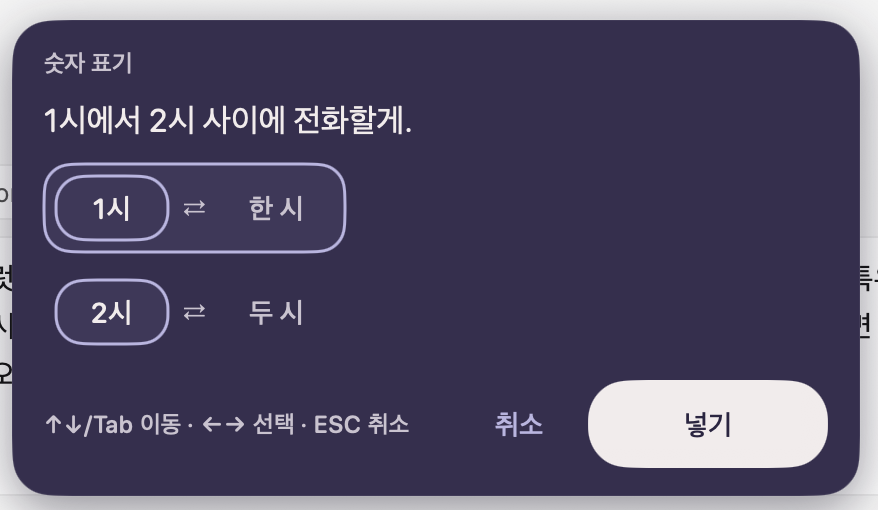
위아래나 Tab으로 옮겨 가고, 왼쪽 오른쪽 화살표로 1시와 한 시를 고릅니다.
첫 버전은 저녁에 만들어서 그날 1.0.0을 올렸습니다. 전날 밤 모델 비교까지 하면 7시간 반쯤입니다.
정말 누구나 앱을 만들 수 있는 세상이 왔네요.
설치 파일은 GitHub에 있습니다.